

Entrenamiento de evaluadores: RET, FOR y BO para reducir sesgos

Actualizado: hace 6 días
¿Dos jefes evalúan al mismo equipo y llegan a conclusiones opuestas? Sin criterios ni evidencia, la calibración termina en discusión. Entrenar a los evaluadores ayuda a trabajar sobre esas diferencias, pero primero hay que entender de dónde vienen.
RET ayuda a reconocer errores al evaluar;
FOR enseña a aplicar un criterio compartido;
BO entrena la observación y el registro durante el ciclo.
No son tres nombres para el mismo taller. Elegir bien exige mirar las notas, revisar casos comunes y comprobar qué evidencia tienen los líderes.
Aquí encontrarás cómo elegir un punto de partida, organizar un plan de 30–60 días y medir sus resultados. Para revisar primero los errores más habituales, consulta cómo evaluar con evidencia y reducir sesgos del jefe.
Por qué los sesgos aparecen incluso en líderes bien intencionados

Evaluar desempeño combina juicio humano, memoria y decisiones que importan: desarrollo, promociones y reconocimientos. La buena intención no basta para que dos personas interpreten de la misma manera una escala o recuerden con igual detalle todo un período.
El halo aparece cuando una fortaleza tiñe la valoración de las demás dimensiones.
La recencia da demasiado peso a lo último que ocurrió;
la primacía, a la primera impresión.
La leniencia o indulgencia y la severidad llevan a usar la escala de manera excesivamente favorable o exigente.
La tendencia central evita distinguir desempeños al concentrar las notas en el medio.
La similitud o afinidad favorece a quien se parece al evaluador.
Reconocer estas señales es útil. Diagnosticarlas requiere algo más. Un jefe con notas altas puede tener un equipo de alto desempeño; dos áreas con promedios distintos pueden enfrentar tareas diferentes. Una distribución llama a revisar, no demuestra por sí sola un sesgo.
El beneficio operativo: menos discusiones sin evidencia
El objetivo no es conseguir que todos pongan la misma nota. Es que las diferencias se puedan explicar con criterios y hechos pertinentes. Eso permite discutir con una mejor base tanto una evaluación individual como las decisiones asociadas al Nine Box.
Menos retrabajo de RRHH, sesiones de calibración más enfocadas y mayor confianza son beneficios que conviene buscar y medir, no resultados que un taller garantice. Por eso el entrenamiento debe conectarse con la calibración del desempeño y con el seguimiento del trabajo durante el ciclo.
Métodos de entrenamiento para evaluadores: RET, FOR y BO

Esta guía se concentra en tres enfoques complementarios. No son los únicos descritos en la literatura: la revisión de Woehr y Huffcutt (1994) también distingue el entrenamiento en dimensiones del desempeño. La pregunta práctica es qué habilidad necesita mejorar tu equipo evaluador.
RET (Rater Error Training): qué es y cuándo aplicarlo
RET enseña a reconocer errores frecuentes del evaluador y a revisar cómo influyen en una calificación. Sirve para que el líder detecte, por ejemplo, que está trasladando un logro reciente a todas las competencias o confundiendo afinidad personal con colaboración.
Un taller práctico presenta sesgos con ejemplos, pide identificar el razonamiento problemático y obliga a volver a la evidencia. La discusión puede partir con una pregunta sencilla: “¿Qué hecho respalda esta nota y a qué criterio corresponde?”. Un checklist previo al cierre ayuda a repetir esa revisión.
Su límite es importante: saber nombrar un sesgo no equivale a evaluar con precisión. RET no define por sí solo qué significa cumplir o exceder una expectativa. Tampoco reemplaza el registro de lo ocurrido durante el año.
Es un buen punto de partida cuando falta un vocabulario común sobre errores o participan evaluadores poco habituales, como puede ocurrir en una evaluación 360°. Si el desacuerdo persiste frente al mismo caso, hay que trabajar también los criterios, no repetir únicamente la explicación de sesgos.
FOR (Frame of Reference Training): cómo crear un estándar compartido
FOR entrena a los evaluadores para interpretar dimensiones y niveles con un marco común. El metaanálisis de Roch y colaboradores (2012) respalda su utilidad para mejorar la precisión de las evaluaciones; el efecto depende, entre otras cosas, de cómo se define y mide esa precisión. No demuestra que cualquier taller produzca el mismo resultado en cualquier organización.
Primero, define qué significa cada nivel. “Cumple” y “excede” necesitan una explicación vinculada al trabajo. Describe conductas, resultados esperados y condiciones relevantes para la familia de cargo. El estándar debe tener fundamento: no basta con acordar una nota por mayoría.
La escala también importa. Puedes revisar cuándo usar escalas GRS o BARS para reducir sesgos en evaluación de desempeño antes de preparar los casos. El entrenamiento debe trabajar con la escala que realmente usarán los líderes.
Después, practica con la misma evidencia. Cada participante califica el caso de manera independiente, explica su decisión y la contrasta con una referencia previamente fundamentada. La conversación se centra en qué conducta se observó, qué nivel describe y qué información falta.
Por último, entrega feedback y vuelve a practicar. El estudio de Hauenstein y McCusker (2017) distingue los efectos sobre acuerdo y precisión. Esa diferencia es clave: coincidir más no basta si todos aplican un criterio equivocado. Usa otro caso para comprobar si lo aprendido se transfiere, en vez de medir solo el acuerdo logrado al discutir el primero.
FOR es especialmente pertinente cuando dos líderes califican de manera diferente la misma evidencia o interpretan de forma incompatible un nivel de la escala. No se trata de borrar diferencias justificadas entre trabajos distintos.
BO (Behavioral Observation Training): cómo observar y registrar durante el ciclo
BO, también denominado BOT, entrena la observación de conductas relevantes y su registro. Su propósito es que la evaluación no dependa de reconstruir el año desde la memoria, especialmente cuando un hecho reciente concentra la atención.
La práctica consiste en distinguir un hecho de una interpretación y registrar incidentes críticos positivos y negativos con contexto suficiente. “No se compromete” es un juicio. “No entregó el informe acordado para el viernes y avisó el lunes” describe algo que se puede contrastar; todavía corresponde conocer las condiciones y la explicación de la persona.
Una nota útil identifica fecha o período, situación, conducta o resultado, criterio relacionado y evidencia disponible. Debe ser pertinente al trabajo, breve y accesible solo para quienes corresponda. Registrar más no autoriza a recopilar detalles personales ajenos al desempeño.
Roch y O’Sullivan (2003) encontraron diferencias entre recordar más información y mejorar su calidad al combinar FOR y entrenamiento de observación. Es una razón para trabajar criterios y evidencia como capacidades distintas, no para prometer que los registros eliminarán todos los errores de memoria.
Prioriza BO cuando las notas no tienen respaldo a lo largo del ciclo o cuando el feedback llega tarde y depende de impresiones generales. Si, además, nadie comparte qué se debe observar, combínalo con FOR.

RET vs FOR vs BO: diferencias, alcance y casos de uso

No hace falta ordenar estos métodos de “superficial” a “muy profundo”. Es más útil comparar qué problema aborda cada uno, cómo se practica y qué deja sin resolver.
Método | Qué trabaja | Práctica central | Límite |
|---|---|---|---|
RET | Reconocer errores del juicio. | Detectar sesgos en casos y justificar la nota con evidencia. | La conciencia no asegura aplicar un estándar correcto. |
FOR | Interpretar criterios y niveles de manera compartida. | Calificar un mismo caso, contrastar una referencia y recibir feedback. | El acuerdo no prueba precisión; necesita criterios pertinentes. |
BO / BOT | Observar y registrar hechos durante el ciclo. | Separar conducta de interpretación y conservar evidencia útil. | Tener registros no garantiza que sean completos, representativos o bien interpretados. |
Como referencia de planificación, puedes reservar 60–90 minutos para RET, 2–4 horas para FOR y 60–120 minutos para un taller inicial de BO. Son rangos orientativos, no dosis validadas ni una promesa de resultados. Ajusta el tiempo a la cantidad de dimensiones, la complejidad de los casos y la práctica que necesiten los participantes.
Cuando también necesitas revisar patrones entre evaluadores, puedes complementar el entrenamiento con análisis de datos y conocer cómo funciona la calibración automática del desempeño con IA. Una alerta analítica debe abrir una revisión del contexto y la evidencia; no convertirse, por sí sola, en un veredicto sobre un jefe.
¿Cuál entrenamiento aplicar primero? Guía por síntomas organizacionales

Empieza con el síntoma que puedas mostrar. La tabla es una orientación inicial, no un diagnóstico definitivo. Antes de comparar notas, separa la familia del cargo evaluado y la relación de evaluación: jefes, pares, colaboradores o autoevaluación observan desde posiciones diferentes.
Señal observable | Qué comprobar primero | Punto de partida | Cómo observar avances |
|---|---|---|---|
Un jefe pone notas sistemáticamente altas o bajas. | Compara criterios, trabajos y evidencia. El promedio puede reflejar desempeño real. | RET si se confirma un error de juicio; FOR si difiere la interpretación del nivel. | Patrones por evaluador y calificación de casos comunes, sin exigir distribuciones iguales. |
Dos jefes discrepan ante la misma evidencia. | Comprueba que el caso esté completo y exista una referencia fundamentada. | FOR con calificación independiente, contraste y feedback. | Acuerdo entre evaluadores y distancia respecto de la referencia. |
La evaluación depende del último hecho recordado. | Revisa qué meses, situaciones y dimensiones tienen respaldo. | BO; añade FOR si no está claro qué observar. | Cobertura del período y calidad de las evidencias, no solo cantidad de notas. |
Se combinan errores de juicio, criterios distintos y registros débiles. | Distingue qué falla en cada grupo antes de repetir un taller general. | RET y FOR según la brecha; instala BO durante el ciclo. | Revisa conjuntamente criterio, acuerdo y cobertura de evidencia. |
No elijas el método por moda: usa el síntoma observable. Si no puedes mostrarlo, diagnostica notas, casos y registros antes de decidir.
Ejemplo hipotético: dos jefes califican con un 2 y un 4 el mismo caso de atención a un cliente. Uno premia haber resuelto el reclamo; el otro penaliza un incumplimiento del procedimiento. Antes de hablar de indulgencia, revisa si la competencia combina ambos criterios y cómo los pondera. El problema puede ser una definición ambigua: FOR debe trabajar esa interpretación, no negociar un 3 para terminar la discusión.
Plan de implementación en 30–60 días: RET, FOR y BO por fases
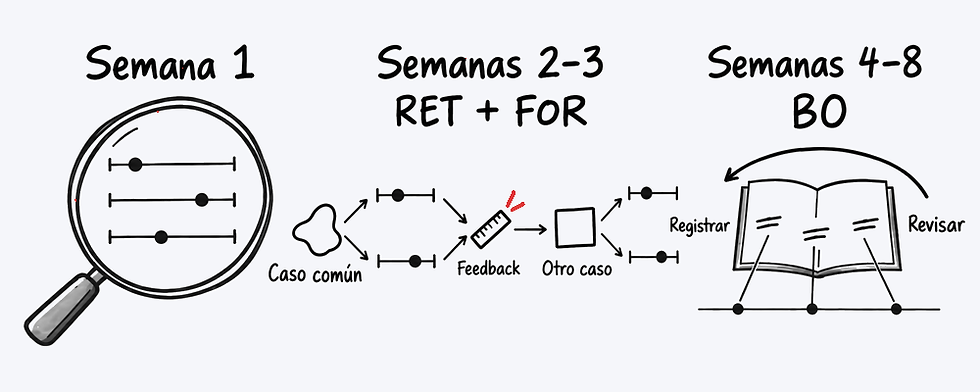
Este plan organiza un piloto. No significa que en 60 días se haya validado todo un sistema ni que sea obligatorio ejecutar los tres talleres con igual intensidad.
Semana 1: diagnóstico de dispersión e incoherencias entre evaluadores
Reúne una muestra de evaluaciones, escalas y registros del ciclo. Dentro de cada familia de cargo y relación de evaluación, identifica diferencias que merezcan revisión. Contrasta también las oportunidades reales de observación: dos personas pueden discrepar porque han visto situaciones distintas, no porque una esté evaluando mal.
Prepara casos comunes con una referencia fundamentada y mide la línea base antes del entrenamiento. Registra dónde se concentran los desacuerdos, qué argumentos aparecen y cuánta evidencia falta. Esto define la prioridad del piloto.
Semanas 2–3: práctica RET y FOR según la brecha detectada
Utiliza RET para reconocer errores que los participantes puedan identificar en decisiones concretas. Dedica FOR a las dimensiones que generan confusión: aclara niveles, pide calificaciones independientes, entrega feedback y repite con un caso distinto.
En formato online, conserva la práctica y la devolución sobre el criterio. Una presentación sin ejercicios no comprueba que el evaluador sepa aplicar lo explicado. La actividad puede organizarse de forma sincrónica o con ejercicios y devolución posterior; no hay que confundir modalidad con calidad del entrenamiento.
Semanas 4–8: BO como hábito de registro y revisión
Reserva un espacio breve y periódico para registrar hechos relevantes. Diez minutos semanales por líder y una revisión mensual de 15 minutos pueden servir como punto de partida organizativo, no como una exigencia universal. No impongas una cuota de incidentes que termine produciendo anotaciones irrelevantes o inventadas.
Revisa si las notas cubren distintos momentos del período, incluyen fortalezas y dificultades, y permiten conversar sobre el trabajo. La guía de gestión del desempeño de OPM recomienda documentación actualizada, ejemplos concretos y conversaciones durante el ciclo. Aquí se toma ese principio operativo, no las reglas administrativas del empleo público estadounidense.
Cómo medir el impacto del entrenamiento de evaluadores

Mide antes de entrenar y vuelve a medir con condiciones comparables. Separa el aprendizaje en los casos del taller de la aplicación en el trabajo: una mejora inmediata no demuestra que el hábito se mantenga durante todo el ciclo.
Indicador | Cómo medirlo | Qué no permite concluir por sí solo |
|---|---|---|
Acuerdo entre evaluadores | Comparar calificaciones independientes del mismo caso y criterio. | Más coincidencia no demuestra que la referencia sea correcta. |
Precisión frente a una referencia | Contrastar las notas con un estándar fundamentado; usar casos equivalentes antes y después. | Aprender un caso no demuestra transferencia a todos los cargos. |
Evidencia disponible | Revisar la proporción de evaluaciones con hechos pertinentes y cobertura del período. | Más registros no equivale a mejores registros. |
Trabajo de calibración | Registrar duración, ajustes y motivos de los cambios. | Menos ajustes no siempre es mejor: detectar problemas puede aumentarlos al inicio. |
Percepción de justicia | Repetir preguntas sobre claridad de criterios, evidencia y posibilidad de explicar el contexto. | Una mejor percepción no demuestra ausencia de sesgos. |
Mantén la misma definición de cada indicador entre mediciones y muestra los tamaños de los grupos. No mezcles observadores para conseguir un promedio más estable ni tomes una baja en la dispersión como objetivo automático. El desempeño puede variar de verdad.
El resultado que buscas es poder defender mejor una decisión: qué se observó, con qué criterio se evaluó, dónde sigue habiendo desacuerdo y qué falta comprobar. El tiempo ahorrado y la confianza son parte de esa evaluación, no sustitutos de ella.
Conclusión: la evaluación justa no se improvisa, se diseña

Si la calibración se vuelve una discusión de impresiones, pedir a los líderes que “sean más objetivos” no alcanza. Necesitan reconocer errores, compartir criterios y llegar con evidencia del período.
RET, FOR y BO permiten trabajar esas capacidades de manera complementaria. El orden y la intensidad deben responder a una brecha comprobable. Empieza con un grupo, usa casos pertinentes y revisa si las decisiones quedan mejor fundamentadas antes de ampliar el entrenamiento.
Lleva el entrenamiento al proceso de evaluación. Revisa la solución de calibración automática del desempeño de TRAKER para conocer su enfoque. La herramienta acompaña el proceso; no reemplaza el criterio profesional ni la revisión de la evidencia.
Preguntas frecuentes sobre entrenamiento de evaluadores

¿Cuánto tiempo dura cada entrenamiento: RET, FOR y BO?
Para organizar un primer piloto, puedes estimar 60–90 minutos para RET, 2–4 horas para FOR y 60–120 minutos para BO, más la práctica durante el ciclo. Son referencias de agenda. La duración adecuada depende de las dimensiones, la experiencia de los evaluadores y los resultados de los ejercicios.
¿Se puede hacer online el entrenamiento de evaluadores?
Sí. Lo importante es que el participante tome decisiones sobre casos y reciba devolución sobre sus razones. Una sesión en vivo no asegura aprendizaje, y un ejercicio con feedback posterior no pierde utilidad por ser asincrónico. Comprueba la aplicación del criterio, no solo la asistencia.
¿Cómo se aplica en evaluaciones 360°?
Prepara ejemplos para cada relación de evaluación y para la familia del cargo. Un jefe, un par y un colaborador pueden observar conductas distintas. FOR ayuda a aclarar los niveles dentro de ese contexto; no obliga a que todas las perspectivas coincidan. Incluye una forma de señalar que no existe evidencia suficiente, en vez de forzar una nota.
¿Cada cuánto hay que repetir RET, FOR y BO?
Revisa las necesidades antes de cada ciclo y cuando cambien competencias, escalas, cargos o participantes. Usa recordatorios de RET y casos breves de FOR donde reaparezcan dificultades. BO requiere seguimiento de los registros durante el período, no repetir una presentación una vez al año. La frecuencia debe responder a las brechas observadas.
¿El entrenamiento de evaluadores reemplaza la calibración?
No. El entrenamiento prepara para observar y aplicar criterios; la calibración revisa cómo se aplicaron en decisiones concretas. Pueden reforzarse mutuamente. Su éxito no se mide por terminar más rápido a cualquier costo, sino por resolver discrepancias con mejores argumentos y evidencia.


Comentarios