
Cómo detectar sesgos en reuniones de calibración

Actualizado: hace 7 horas
¿Qué ocurre cuando una evaluación pasa de manos del supervisor a una mesa de líderes? Puede ganar consistencia, pero también perder contexto, tiempo y trazabilidad. Los casos y experimentos de esta investigación muestran cómo recuperar una conversación más justa sin confundir acuerdo con calidad.
En este artículo:
La calibración quiere apagar sesgos, pero a veces les pone micrófono
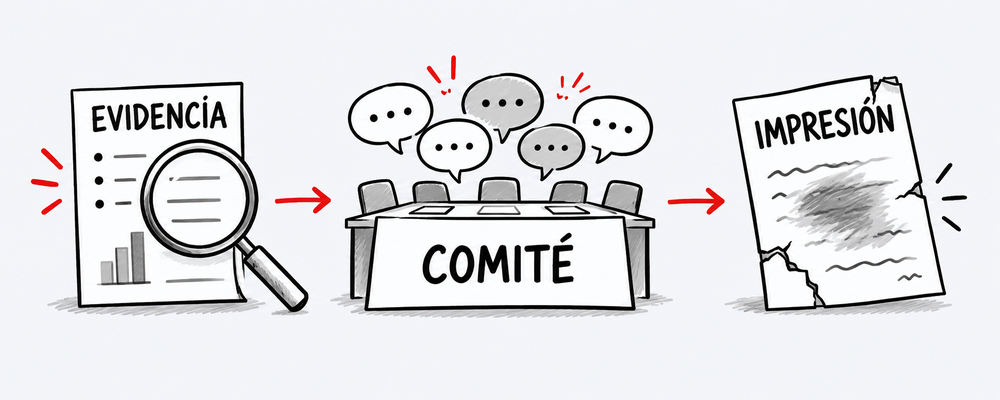
Las reuniones de calibración nacieron con una misión razonable: evitar que cada jefe evaluara con su propia regla, como si las calificaciones fueran recetas familiares y cada uno guardara una versión secreta del “a gusto”. Pero una buena intención no siempre produce un buen resultado. A veces, al intentar corregir un sesgo, la organización termina invitando a otros a la reunión, les sirve café y les entrega un micrófono.
El punto central es este: calibrar no garantiza evaluar justamente. El proceso puede reducir la tendencia de algunos supervisores a calificar a todo el mundo demasiado alto, pero también puede empujar las notas hacia el promedio, amplificar estereotipos y permitir que la conversación se aleje de la evidencia. La solución no consiste necesariamente en eliminar la calibración, sino en diseñarla con reglas que hagan más difícil que el sesgo se disfrace de consenso.
Si participas en una de estas reuniones, la pregunta práctica es incómoda: ¿la calificación resume evidencia compartida o la impresión que consiguió imponerse en la sala?
El proceso suele comenzar con el supervisor directo. Esa persona evalúa a sus colaboradores y asigna una calificación general. Después se reúne con otros supervisores y líderes para conversar sobre las notas y ajustarlas de manera consistente en toda la organización.
En teoría, el empleado es evaluado dos veces: primero por su jefe y luego por el comité de calibración. El objetivo es reducir el favoritismo y lograr que una misma escala signifique algo parecido en equipos distintos.
La investigación citada en la fuente muestra que el mecanismo sí logra reducir un sesgo específico: la tendencia a evaluar con indulgencia, es decir, poner una nota más alta de la que correspondería al desempeño observado. Ese efecto es útil, pero acotado.
El problema aparece cuando se concluye que corregir la indulgencia equivale a corregir todos los sesgos. Sería como reparar un reloj atrasado y declarar que, desde ese momento, también quedó arreglada la cafetera.
El primer problema: todos terminan pareciendo promedio
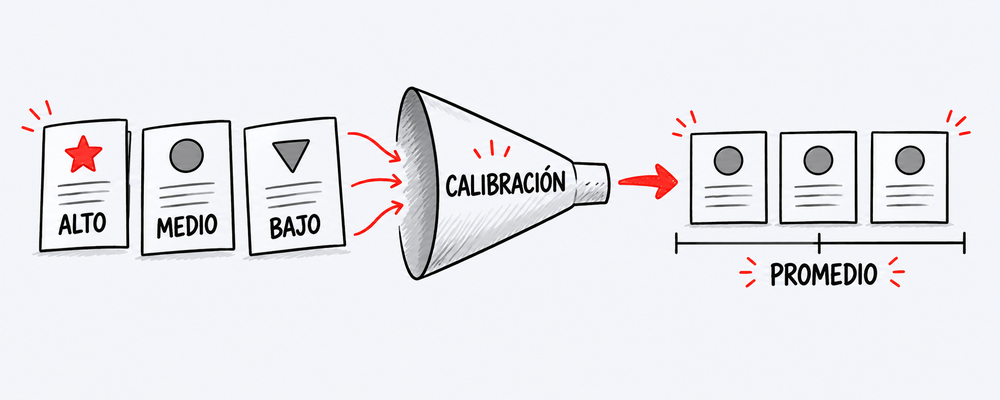
Las reuniones de calibración pueden aumentar la tendencia a ubicar a más personas en el centro de la escala. En vez de distinguir con claridad entre desempeño alto, medio y bajo, la conversación puede terminar produciendo una gran familia de “cumple, más o menos”.
Eso perjudica a todos, aunque de maneras distintas:
Quienes tienen un desempeño bajo pueden quedarse sin una señal clara sobre qué deben mejorar.
Quienes tienen un desempeño alto pueden recibir menos reconocimiento del que merecen.
Quienes se encuentran en la mitad pueden recibir el mensaje desmotivador de que son simplemente promedio.
Una evaluación que evita cualquier diferencia puede parecer prudente en una planilla, pero es poco útil para tomar decisiones de desarrollo, promoción o apoyo. Si todos aparecen como “más o menos”, la organización obtiene una fotografía borrosa justo cuando necesitaba enfocar.
Cuando el consenso fabrica una desventaja
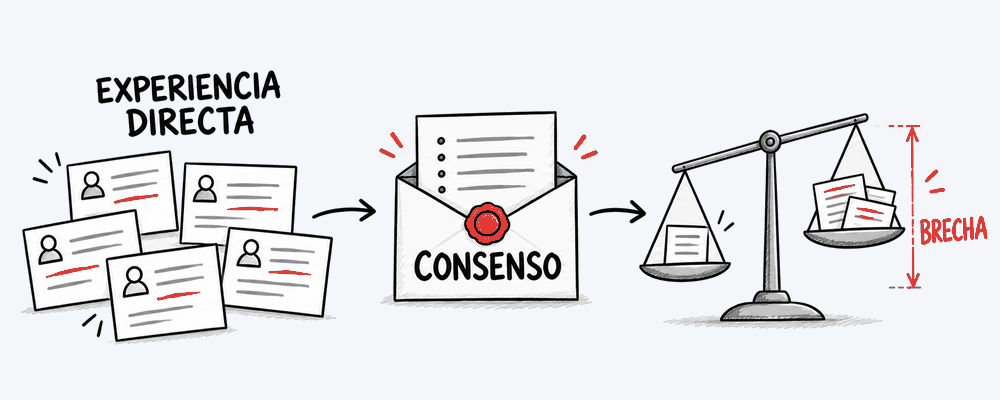
El caso más preocupante de la fuente surge de un análisis detallado de las evaluaciones en un estudio jurídico. Allí, los socios calificaban a las personas con las que habían trabajado, pero quienes eran evaluados nunca veían esas opiniones individuales.

En su lugar, un grupo pequeño de socios calibraba las evaluaciones de los supervisores y redactaba una evaluación de consenso para entregarla al asociado. El resultado podía sonar ordenado, pero tenía una falla importante: la persona no sabía quién había dicho qué ni podía pedir más información a un supervisor específico. Tampoco podía construir con esa persona un plan concreto de mejora.
La calibración introdujo además una diferencia enorme en la percepción del valor profesional de las mujeres de color. En las evaluaciones de sus supervisores, solo había una diferencia de dos puntos porcentuales entre el porcentaje de hombres blancos y mujeres de color descritos como activos valiosos. Después de la calibración, esa diferencia llegó a 34 puntos porcentuales.
Suponiendo que los abogados tenían un talento equivalente, el análisis concluyó que el proceso de consenso reforzó estereotipos raciales y de género sobre quién parecía valioso, aunque las personas que trabajaban directamente con ellos los hubieran visto como prácticamente iguales.
La experiencia directa marcaba la diferencia. Quienes habían colaborado con las mujeres de color evaluadas tendían a valorar su desempeño de manera comparable al de los hombres blancos. Cuando faltaba conocimiento de primera mano, los estereotipos encontraban más espacio para ocupar la sala. El patrón no afectaba solo a asociados jóvenes: también aparecía en personas con rango de senior counsel.
Dos sesgos que se cuelan por la puerta trasera
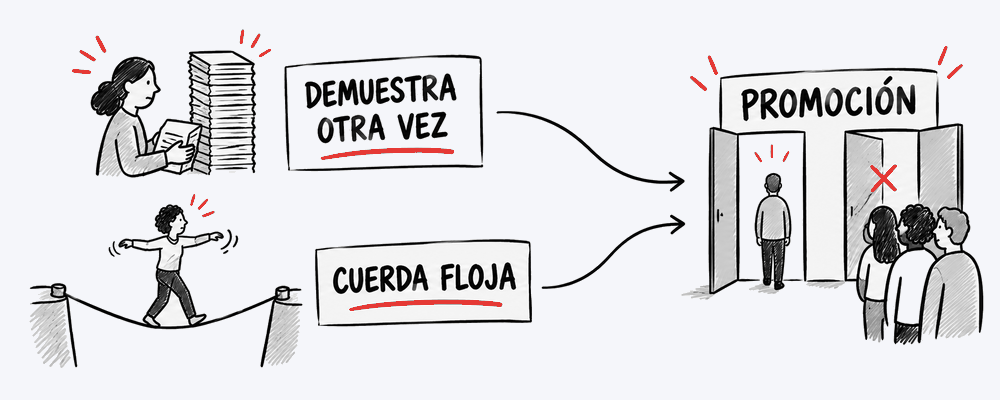
La investigación pone el foco en dos formas de sesgo especialmente relevantes.
El primero es el sesgo de “demuéstralo otra vez”. Algunas personas necesitan entregar más pruebas que otras para ser consideradas competentes o con potencial. En el caso estudiado, las mujeres blancas tenían, según sus supervisores, 12 puntos porcentuales más de probabilidad que los hombres blancos de ser descritas como personas con potencial. Después de la calibración, pasaron a tener cinco puntos porcentuales menos de probabilidad que ellos.
La consecuencia es importante: otra investigación citada en la fuente encontró que hasta la mitad de la diferencia en promociones entre hombres y mujeres podía explicarse por las distintas calificaciones de potencial incluidas en las evaluaciones de desempeño.
El segundo es el sesgo de la cuerda floja. A algunas personas se les permite un rango más amplio de comportamientos; otras deben moverse con cuidado para no ser percibidas como difíciles, enojadas o intimidantes. El mismo comportamiento que en un hombre blanco puede interpretarse como firmeza, en una persona de color puede recibir una lectura más negativa.
En el estudio jurídico, los hombres de color terminaron teniendo 11 puntos porcentuales más de probabilidad que los hombres blancos de ser descritos como “bien queridos”, cuando en las evaluaciones de los supervisores la diferencia era de solo dos puntos.
¿El problema de ser bien querido? No, por supuesto. El problema es que la frase puede convertirse en una exigencia adicional: ser bueno en el trabajo y, además, caerle extraordinariamente bien a todo el mundo. Mientras tanto, a otros grupos se les permite avanzar por los méritos de su trabajo. La simpatía se vuelve requisito oculto y la evaluación lo deja escrito con tinta invisible, que es la más difícil de discutir.
La agenda, el formulario y la conversación también sesgan
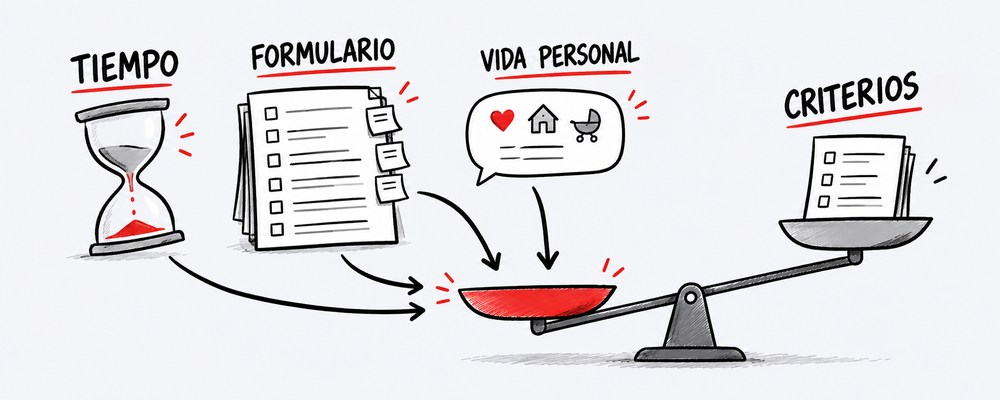
El proceso puede volverse injusto incluso sin una frase abiertamente discriminatoria. La estructura —o la falta de ella— también distribuye ventajas.
Una empresa tecnológica organizó reuniones de calibración durante dos días para revisar las evaluaciones de 100 empleados. En ambos días se acabó el tiempo. Las personas revisadas al comienzo recibieron más conversación; quienes aparecieron al final tuvieron que conformarse con el equivalente corporativo a “lo vemos después”.
Si determinados grupos son juzgados con más frecuencia por su potencial y otros no, la hora del día puede terminar afectando la nota. No porque el desempeño haya cambiado entre la mañana y la tarde, sino porque la atención, el tiempo y la energía del comité sí cambian.
En otra empresa, el formulario incluía tantos criterios que era imposible discutirlos todos. Además, nadie registraba de manera consistente lo que se decía sobre cada persona. El resultado fue que los empleados terminaron siendo evaluados con criterios distintos. Cuando no se usa la misma evidencia, la misma escala y criterios comparables, el sesgo entra por cualquier rendija.
También se observaron comentarios sobre la vida personal: problemas matrimoniales, condición parental e incluso apariencia. Son asuntos irrelevantes para evaluar el desempeño y, precisamente por eso, nunca deberían convertirse en material de una reunión de calibración.
Cuando la reunión se transforma en un espacio sin estructura, aparece otra tentación: el lobby. Un exlíder senior de Amazon llegó a recomendar que los empleados identificaran y cultivaran relaciones con quienes participaban en las reuniones para dejar una buena impresión. Esta estrategia puede ser más sencilla para las personas que ya pertenecen al grupo interno de influencia, típicamente hombres blancos y extrovertidos.
Pero una evaluación justa no debería exigir que el empleado se convierta en candidato permanente de una campaña electoral. Es responsabilidad de la organización construir un proceso confiable para todos.
Tres ajustes para calibrar con más justicia
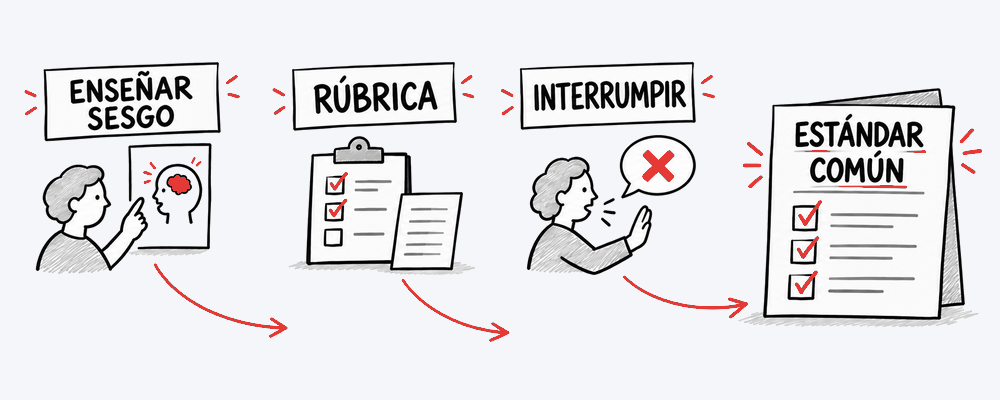
Eso no obliga a desechar todo el proceso. Hay pequeños cambios capaces de interrumpir los sesgos sin tirarlo por la ventana.
Enseñar cómo se ve el sesgo. Las personas suelen reconocer los estereotipos raciales, étnicos o de género más evidentes, pero pueden no identificar el sesgo de la cuerda floja, el de “demuéstralo otra vez”, el muro de la maternidad o el sesgo de tira y afloja. Quienes participan en la calibración necesitan aprender a detectarlos antes de que parezcan comentarios normales.
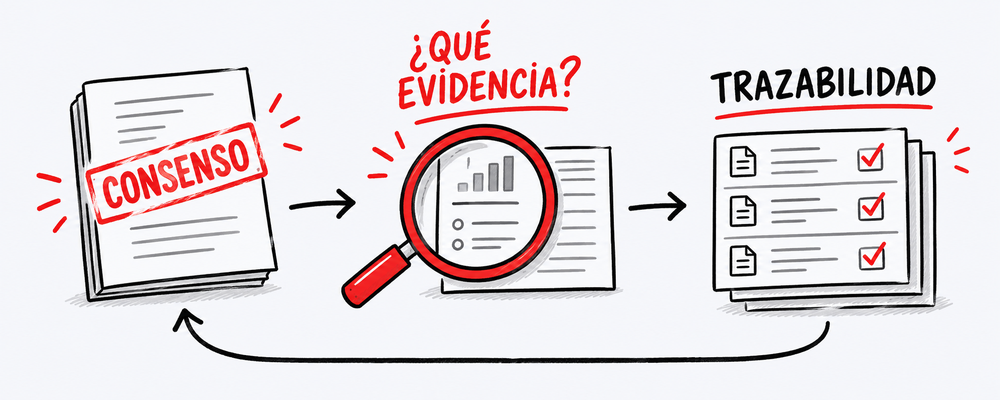
Usar una rúbrica breve, consistente y basada en evidencia. Cada persona debe ser evaluada con competencias relevantes para su trabajo, expectativas concretas y la misma escala. Además, los participantes deberían entregar por escrito, antes de la reunión, dos o tres evidencias que respalden cada valoración.
Asignar interrupciones de sesgo. Algunas personas deben tener la tarea explícita de buscar señales de sesgo y reconducir la conversación hacia los criterios acordados. Una pregunta sencilla puede funcionar como freno de emergencia: “¿Esto es relevante para la rúbrica?”.
Estas medidas cambian quién puede opinar, con qué información y bajo qué estándar. Y esas tres cosas suelen decidir más que el nombre elegante de la reunión.
Qué cambia cuando se obliga a usar evidencia
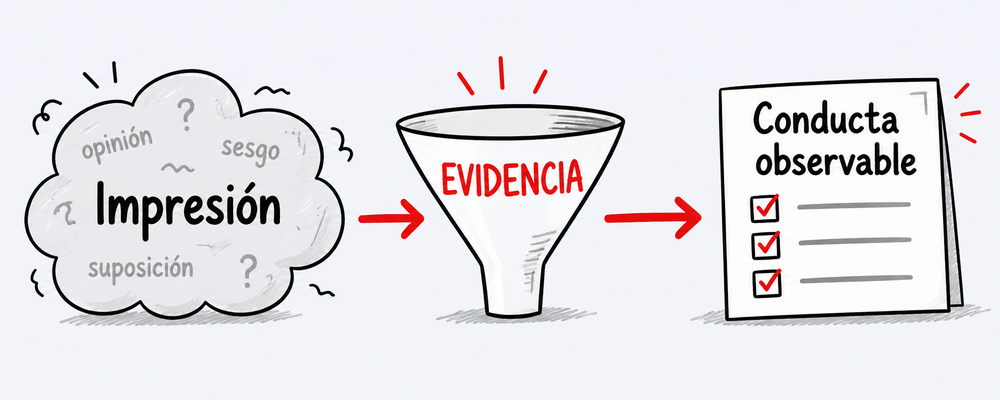
Dos resultados concretos de la fuente muestran por qué importa la estructura.
En un experimento con un estudio jurídico de tamaño mediano, enseñar a los evaluadores cómo se manifiestan los sesgos redujo de manera drástica los comentarios negativos sobre la personalidad de personas de color: pasaron de representar 14 % antes de la intervención a 0 % después.
En otro experimento, realizado con una gran empresa minorista, solo 43 % de los empleados recibía comentarios basados en evidencia en sus evaluaciones. Al cambiar a una rúbrica con expectativas concisas y específicas, los gerentes encontraron más fácil fundamentar sus valoraciones. La proporción de empleados que recibió retroalimentación basada en evidencia subió a 87 %.
La evidencia no elimina automáticamente todos los prejuicios, pero obliga a que la conversación vuelva a una pregunta más defendible: ¿qué conducta o resultado observable respalda esta valoración? Esa pregunta no resuelve por sí sola una historia de desigualdades, pero sí reduce el espacio para impresiones vagas, preferencias personales y comentarios que no tienen nada que ver con el trabajo.
Preguntas frecuentes sobre calibración y sesgos
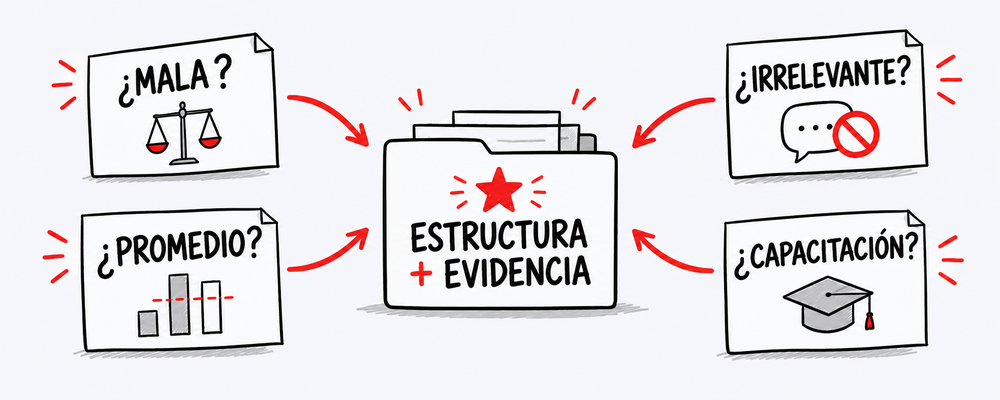
¿La calibración es mala por definición? No. Puede reducir la indulgencia de algunos supervisores y ayudar a que las evaluaciones tengan estándares más comparables. El riesgo aparece cuando la reunión carece de estructura, evidencia y mecanismos para detectar sesgos.
¿Por qué una calificación promedio puede ser injusta? Porque mezcla desempeños diferentes y deja a las personas sin una señal clara. Quien necesita mejorar no recibe orientación suficiente y quien sobresale puede quedar sin reconocimiento.
¿Qué debería hacer un participante si escucha un comentario irrelevante? Pedir que se vuelva al criterio acordado. La pregunta “¿Esto es relevante para la rúbrica?” ayuda a frenar comentarios sobre simpatía, apariencia o vida personal.
¿Basta con capacitar sobre sesgos? La capacitación ayuda, pero funciona mejor junto con una rúbrica breve, evidencia presentada por escrito antes de la reunión y una persona encargada de interrumpir los sesgos durante la conversación.
La pregunta que debería quedar al cierre
Las evaluaciones de desempeño pretenden entregar confianza o una señal de alerta. Para que cumplan esa función, deben ayudar a promover y retener a las personas más valiosas, además de indicar con claridad dónde hace falta apoyo y desarrollo.
La investigación citada encontró sesgos raciales y de género en casi todas las empresas evaluadas. Eso no significa que el sesgo sea inevitable. Significa que una organización responsable debe diseñar el proceso suponiendo que puede aparecer, incluso cuando todos los participantes tengan buenas intenciones.
La fuente original reconoce a Walmart por el apoyo financiero que permitió parte de esta investigación.
La próxima vez que un comité diga que llegó a un consenso, conviene hacer una pausa antes de celebrar. Un consenso puede ser una conclusión razonada; también puede ser simplemente el momento en que nadie quiso volver a preguntar por la evidencia. La diferencia está en la estructura: mismos criterios, información comparable, registros claros y permiso explícito para interrumpir lo injusto.
En organizaciones que buscan conectar mejor sus evaluaciones con el desarrollo y las decisiones de talento, una plataforma de gestión del desempeño puede ayudar a ordenar evidencias, hacer comparables los criterios y dejar trazabilidad. Eso no reemplaza el juicio humano: evita que el juicio tenga que trabajar a oscuras.


Comentarios